Kimi k3 技术报告详解(1)——架构再升华
前言
在看到kimi k3的技术报告后,再次被狠狠震惊到,体系架构的更新并集成到LLM中,成功实现了open frontier intelligence! 本人由于没啥机会无法体验到k3带来的震撼感,但已然从技术报告中感受到了一种大招释放的爽度,因此打算详细梳理技术报告里包含的各种细节。不足之处尽请讨论~
模型架构
架构的整体更新,取决于三个维度:
- sequence length 这一部分主要是混合注意力机制的应用,DeltaAttention的硬件成功应用使得混合注意力的效能再次拔高了一个层次,k3主要是三层KDA和一层GatedMLA,而这里面的如gate、conv等要件都已经被充分验证的有效性,因此这次属于在scale的层次上再次验证了hybird的有效性;
- network depth 这是对模型深度的探索,实际是对残余信息的充分利用,使得整体的信息量使用效率提高,且对于分布式训练环境取得了系统级的提升;
- model width 则是对MoE的进一步优化,实现Stable LatentMoE以做到高效激活对应专家信息的token
而其余如Per-Head Muon优化器或加入视觉能力,本质上是对scale能力的提升。接下来将详细讲解这些模块的细节和功能

Hybird Attention
混合注意力很显然是线性注意力和全量注意力和混合,线性注意力的O(n)使得模型能够进一步处理长序列信息,而全量注意力保留了完整的信息,通常学习全局信息。
Kimi Delta Attention
我们从全量注意力,也就是softmax开始推导: \(\begin{equation} \color{purple}{ \boldsymbol{O} = \mathop{\text{softmax}}(\boldsymbol{Q}\boldsymbol{K}^{\top} + \log \boldsymbol{M})\boldsymbol{V} } \end{equation}\)
这里省略了缩放因子,而$M$是个下三角掩码矩阵,log后对里面的元素注意取对数,以实现causal的效果。而softmax需要进行$n*n$的矩阵运算计算$exp(QK^T)$,导致了平方复杂度:
\[\begin{equation} \color{purple}{ \boldsymbol{O} = \exp(\boldsymbol{Q}\boldsymbol{K}^{\top} + \log \boldsymbol{M})\boldsymbol{V} = (\exp(\boldsymbol{Q}\boldsymbol{K}^{\top})\odot \boldsymbol{M})\boldsymbol{V} } \end{equation}\]而线性注意力就是为了近似softmax并取得线性复杂度的效果,最简单的方案就是去到指数$exp$:
\[\begin{equation} \color{purple}{ \boldsymbol{O} = (\boldsymbol{Q}\boldsymbol{K}^{\top}\odot \boldsymbol{M})\boldsymbol{V} } \end{equation}\]从分量进一步理解: \(\begin{equation} \color{purple}{ \boldsymbol{o}_t = \sum_{j=1}^t \boldsymbol{v}_j (\boldsymbol{k}_j^{\top} \boldsymbol{q}_t) = \sum_{j=1}^t (\boldsymbol{v}_j \boldsymbol{k}_j^{\top}) \boldsymbol{q}_t = \left(\sum_{j=1}^t \boldsymbol{v}_j \boldsymbol{k}_j^{\top}\right) \boldsymbol{q}_t } \end{equation}\)
我们将括号记为$S_t$,这样就有
\[\begin{equation} \color{purple}{ \boldsymbol{o}_t = \boldsymbol{S}_t \boldsymbol{q}_t, \qquad \boldsymbol{S}_t = \boldsymbol{S}_{t-1} + \boldsymbol{v}_t \boldsymbol{k}_t^{\top} } \end{equation}\]这样就是以$S_t$作为State的线性RNN形态了
接下来,我们引入delta-rule,其目的在于解决上述等权叠加导致信息稀疏的问题,核心仍然在对State $S_t$的更新:
\[\begin{equation} \color{purple}{ \begin{aligned} \boldsymbol{S}_t &= \boldsymbol{S}_{t-1} - \underbrace{(\boldsymbol{S}_{t-1} \boldsymbol{k}_t)}_{\boldsymbol{v}_t^{\text{old}}} \boldsymbol{k}_t^{\top} + \underbrace{(\beta_t \boldsymbol{v}_t + (1-\beta_t)\boldsymbol{S}_{t-1}\boldsymbol{k}_t)}_{\boldsymbol{v}_t^{\text{new}}} \boldsymbol{k}_t^{\top} \\ &= \boldsymbol{S}_{t-1}(\mathbf{I} - \beta_t \boldsymbol{k}_t \boldsymbol{k}_t^{\top}) + \beta_t \boldsymbol{v}_t \boldsymbol{k}_t^{\top} \end{aligned} } \end{equation}\]尽管形式上复杂,但概念上好理解。更新的状态就是删去旧状态并加入新状态,而里面的$\beta_t$表示写入的权重大小。整体简化后就是给旧状态$S_{t-1}$加入了Householder传输矩阵的权重,并更新新状态。
进一步,可以加入遗忘门稀疏等权信息的问题,而从SLiCE这篇文章中我们可知,低秩对角矩阵可以拥有最大的表达力,因此KDA从形式上就很清晰了:
\[\begin{equation} \color{purple}{ \mathbf{S}_t = (\mathbf{I} - \beta_t \boldsymbol{k}_t \boldsymbol{k}_t^{\top}) \operatorname{Diag}(\boldsymbol{\alpha}_t) \mathbf{S}_{t-1} + \beta_t \boldsymbol{k}_t \boldsymbol{v}_t^{\top}, \qquad \tilde{\boldsymbol{o}}_t = \mathbf{S}_t^{\top} \boldsymbol{q}_t. } \end{equation}\]Chunkwise parallel form
要实现与GPU硬件对齐的算法设计,分块并行方法已经是公认的有效方式。核心思路就是块与块之间串行递归,块内部进行并行计算。
首先,将长序列切成长度为 $C$ 的小段, $\mathbf{X}_{[t]}$ 表示第 $t$ 个块中所有向量的堆叠; $\mathbf{S}_{[t]}$ 表示进入第 $t$ 块时的递归状态。我们就会有通道级的累计衰减:
\[\begin{equation} \color{purple}{ \boldsymbol{\gamma}_{[t]}^{i \to j} := \prod_{r=i}^{j} \boldsymbol{\alpha}_{[t]}^{r}, \qquad \boldsymbol{\gamma}_{[t]}^{r} := \boldsymbol{\gamma}_{[t]}^{1 \to r}. } \end{equation}\]这里指的是从位置 i 到 j 的累积衰减,从遗忘门的对角矩阵 $\boldsymbol{\alpha}_{[t]}^r$ 得到。我们将从1到C所有的衰减按行堆叠得到 $\boldsymbol{\Gamma}_{[t]}^{1 \to C} \in \mathbb{R}^{C \times d_k}$ ,之后利用上三角变换 (UT变换),定义辅助矩阵 $\mathbf{M}_{[t]}$ 将块内所有 token 之间的衰减和 delta 修正关系编码,然后
\[\begin{equation} \color{purple}{ \mathbf{W}_{[t]} = \mathbf{M}_{[t]} (\boldsymbol{\Gamma}_{[t]}^{1 \to C} \odot \mathbf{K}_{[t]}), \qquad \mathbf{U}_{[t]} = \mathbf{M}_{[t]} \mathbf{V}_{[t]} } \end{equation}\]这样通过一次矩阵求逆就可以把原本需要逐个 token 计算的依赖关系批量处理, $\mathbf{U}_{[t]}$ 和 $\mathbf{W}_{[t]}$ 也可以在块内计算。而对于伪值项的定义
\[\color{purple}{ \widetilde{\mathbf{V}}_{[t]} := \mathbf{U}_{[t]} - \mathbf{W}_{[t]} \mathbf{S}_{[t]} }\]它就能将输出拆分成两部分:
\[\begin{equation} \color{purple}{ \begin{aligned} \mathbf{A}_{[t]} &= \operatorname{Tril}\left[(\mathbf{Q}_{[t]} \odot \boldsymbol{\Gamma}_{[t]}^{1 \to C})(\mathbf{K}_{[t]} / \boldsymbol{\Gamma}_{[t]}^{1 \to C})^{\top}\right], \\ \mathbf{O}_{[t]} &= \underbrace{(\boldsymbol{\Gamma}_{[t]}^{1 \to C} \odot \mathbf{Q}_{[t]}) \mathbf{S}_{[t]}}_{\text{inter-chunk}} + \underbrace{\mathbf{A}_{[t]} \widetilde{\mathbf{V}}_{[t]}}_{\text{intra-chunk}}. \end{aligned} } \end{equation}\]这里的$\mathbf{A}_{[t]}$是带衰减的因果注意力矩阵,用于块内注意力打分;而输出明显分成块与块之间和块内部,实现了块之间串行递归,块内部并行计算的特点,且保持数学等价性,结果和逐 token 递归完全一致。
进一步观察,$\boldsymbol{\Gamma}_{[t]}^{1 \to C}$给每个键值都进行了缩放,如果某些$\alpha$很小,整体的倒数就会趋向无穷大导致溢出。以前的做法是把每个 chunk 再细分为 16-token 的 tiles,但由于衰减的因果性对角线部分仍需要逐个位置对计算。
为了解决对角线这个瓶颈,衰减因子的映射从
\[\begin{equation} \color{purple}{ g_t^h = -e^{A_h} \text{Softplus}(z_t^h) \in (-\infty, 0) } \end{equation}\] \[\begin{equation} \color{purple}{ \alpha_t^h = \exp(g_t^h) \in (0, 1) } \end{equation}\]变化为
\[\begin{equation} \color{purple}{ g_t^h = g_{\min} \cdot \text{Sigmoid}\left(e^{A_h} z_t^h\right) \in (g_{\min}, 0) } \end{equation}\] \[\begin{equation} \color{purple}{ \alpha_t^h = \exp(g_t^h) \in (e^{g_{\min}}, 1) } \end{equation}\]Sigmoid 映射给衰减因子$\alpha$加了硬下界,倒数被锁定在安全范围内。这样所有的元素都可以通过 Tensor Core 的 dense matmul进行矩阵计算,速度更快。

Gated MLA
Multi-head Latent Attention (MLA)在我以前的博客有所涉及:DeepSeek-V2,其本质就是压缩了键值的表征,以缓解kv cache带来的大量缓存问题,而kimi k3将其应用到最后一层的全局表征中,并不使用位置编码(由于全局特征无需受到位置限制的交互),以及加入了门控机制,门控机制在Qwen的研究中已经完全验证其有效性。
最终的输出如下所示:
\[\begin{equation} \color{purple}{ \mathbf{y}_t = \mathbf{W}_o \left[ \mathrm{Sigmoid}(\mathbf{W}_g \mathbf{x}_t) \odot \mathrm{RMSNorm}(\tilde{\boldsymbol{o}}_t) \right] } \end{equation}\]其中$\mathbf{W}_g$就是门控机制,用于调制全局信息的token强度
Attention Residuals
我们首先看一下全量注意力的残差是如何设计的:
\[\begin{equation} \color{purple}{ \boldsymbol{k}_i = \boldsymbol{v}_i = \begin{cases} \boldsymbol{h}_1 & i = 0 \\ f_i(\boldsymbol{h}_i) & 1 \leq i \leq l-1 \end{cases} } \end{equation}\]其中键$k_i$值$v_i$来自前面所有层的输出,$f_i$表示第$i$个输出层,$h_1$是token的嵌入embedding,Softmax kernel被表示为$\phi(\boldsymbol{q}, \boldsymbol{k}) = \exp\left(\boldsymbol{q}^\top \mathrm{RMSNorm}(\boldsymbol{k})\right)$,全局注意力可以表示为如下形式:
\[\begin{equation} \color{purple}{ \alpha_{i \to l} = \frac{\phi(\boldsymbol{q}_l, \boldsymbol{k}_i)}{\sum_{j=0}^{l-1} \phi(\boldsymbol{q}_l, \boldsymbol{k}_j)}, \quad \boldsymbol{h}_l = \sum_{i=0}^{l-1} \alpha_{i \to l} \cdot \boldsymbol{v}_i } \end{equation}\]显然,标准注意力是在层与层之间进行,而上述的KDA这是块(block)之间的相互作用,也就是序列维度而非层维度,所以需要设计块之间的注意力残差(Block Attention Residuals)
具体而言,我们将L层分成N个块,每块$S=L/N$层,块内部通过求和压缩为单个表示为\(\color{purple}{\boldsymbol{b}_n = \sum_{j \in \mathcal{B}_n} f_j(\boldsymbol{h}_j)}\)
块间就只在N个块级做注意力:
\[\begin{equation} \color{purple}{ \mathbf{V} = \begin{cases} [\boldsymbol{b}_0, \boldsymbol{b}_1, \ldots, \boldsymbol{b}_{n-1}]^\top & \text{if } i = 1 \\ [\boldsymbol{b}_0, \boldsymbol{b}_1, \ldots, \boldsymbol{b}_{n-1}, \boldsymbol{b}_n^{i-1}]^\top & \text{if } i \geq 2 \end{cases} } \end{equation}\]总结来说,标准残差是每层只能看前一层,这里是每层可以看所有前面层,并用注意力决定谁更重要。Block 版本通过分块压缩进一步将复杂度压缩到N级别。
Stable LatentMoE
初探MoE及其问题
我们先从MoE开始一步步推导。MoE就是稀疏dense的一种方式,因为它将dense那种高维大量宏观的信息转移到每个专家块中进行处理,在inference时就只需激活某个领域的专家即可,通常也会达到dense模型的效果,而标准的MoE主要由两部分组成:
- Router:专门训练用于决定每个 token 应该交给哪一个专家来处理的;
- Expert:每一层前馈神经网络由多个“专家”组成。
当然,这只是很笼统且直观的说法,下来我们将从几何意义出发理解MoE模型:
以MLP作为FFN层为例,得到的式子如下:
\[\begin{equation} \color{purple}{ \boldsymbol{y} = f(\boldsymbol{x}\boldsymbol{W}^{(A)})\boldsymbol{W}^{(B)} } \end{equation}\]其中 $x$ 为输入向量,${W}^{(A)}$ 和 ${W}^{(B)}$ 是可学习的参数矩阵, $f$ 是激活函数,为了直观体现MoE的作用,我们可以把它等价地用分块矩阵写成:
\[\begin{equation} \color{purple}{ \boldsymbol{y} = f\big(\boldsymbol{x}\begin{bmatrix}\boldsymbol{W}^{(A)}_1 & \boldsymbol{W}^{(A)}_2 & \cdots & \boldsymbol{W}^{(A)}_n\end{bmatrix}\big)\begin{bmatrix}\boldsymbol{W}^{(B)}_1 \\ \boldsymbol{W}^{(B)}_2 \\ \vdots \\ \boldsymbol{W}^{(B)}_n\end{bmatrix} = \sum_{i=1}^n \underbrace{f(\boldsymbol{x}\boldsymbol{W}^{(A)}_i)\boldsymbol{W}^{(B)}_i}_{\boldsymbol{v}_i} } \end{equation}\]由此,FFN就等价的表示成 $n$ 个向量 ${v}_1,{v}_2,\cdots,{v}_n$ 的和,而这些小模型就是MoE中的Expert单元。于是,MoE在这里想研究的问题就是能否只挑 $k$ 个向量的和来逼近 $n$ 个向量的和呢?这样计算量就降低到 $k/n$ 了?
从低秩近似的角度理解,它就是挑选模长最大的 $k$ 个向量(Top-k算法),然而问题是我们还需要先计算出所有的模长再比大小,这显然违背了我们当初的想法。
为了解决这个矛盾,我们得重新设计Expert单元,做法是先将 $v_i$ 归一化得到 $e_i = {v}_i/\Vert{v}_i\Vert$,这样模长就相同了,下来定义
\[\begin{equation} \color{purple}{ \underbrace{[\rho_1,\rho_2,\cdots,\rho_n]}_{\boldsymbol{\rho}} = h(\boldsymbol{x}\boldsymbol{W}^{(R)})\quad\in\mathbb{R}_{\geq 0}^n } \end{equation}\]这实际上就是从 $d$ 维到 $n$ 维的线性变换操作,也就是MoE模型中的Router。本质上它将计算Expert分为计算量较小的计算模长和计算量较大的计算方向两部分,这样我们可以先计算模长,找到最大的 $k$ 个后,再计算对应的方向,最后相乘得到结果:
\[\begin{equation} \color{purple}{ \boldsymbol{y} = \sum_{i\in \mathop{\text{argtop}}_k \boldsymbol{\rho}} \rho_i \boldsymbol{e}_i } \end{equation}\]而为了更深入的利用好MoE模型,关键就是提升模型的宽度,以实现专家库和激活专家的数量提升。然而这里的关键问题是,传统MoE模型对于每个选定的专家,都会收到完整的 $d$ 维表示,这大大提高了通信和专家权重的负载量,而LatentMoE将隐藏维度 $d$ 降低至 $\ell=d/\alpha$ ;具体来说就是共享专家依然保留全宽,而激活专家则在 $\ell$ 宽度的潜空间训练,但如此放大专家量也带来了两大问题:
- Router部分降维再升维带来了四个矩阵相乘的爆炸式的内部激活;
- 需要平衡近1000个专家模块,现有的辅助损失策略并不完善
而Stable LatentMoE就是改善这两大问题衍生的方法
Sigmoid Tanh Unit GLU
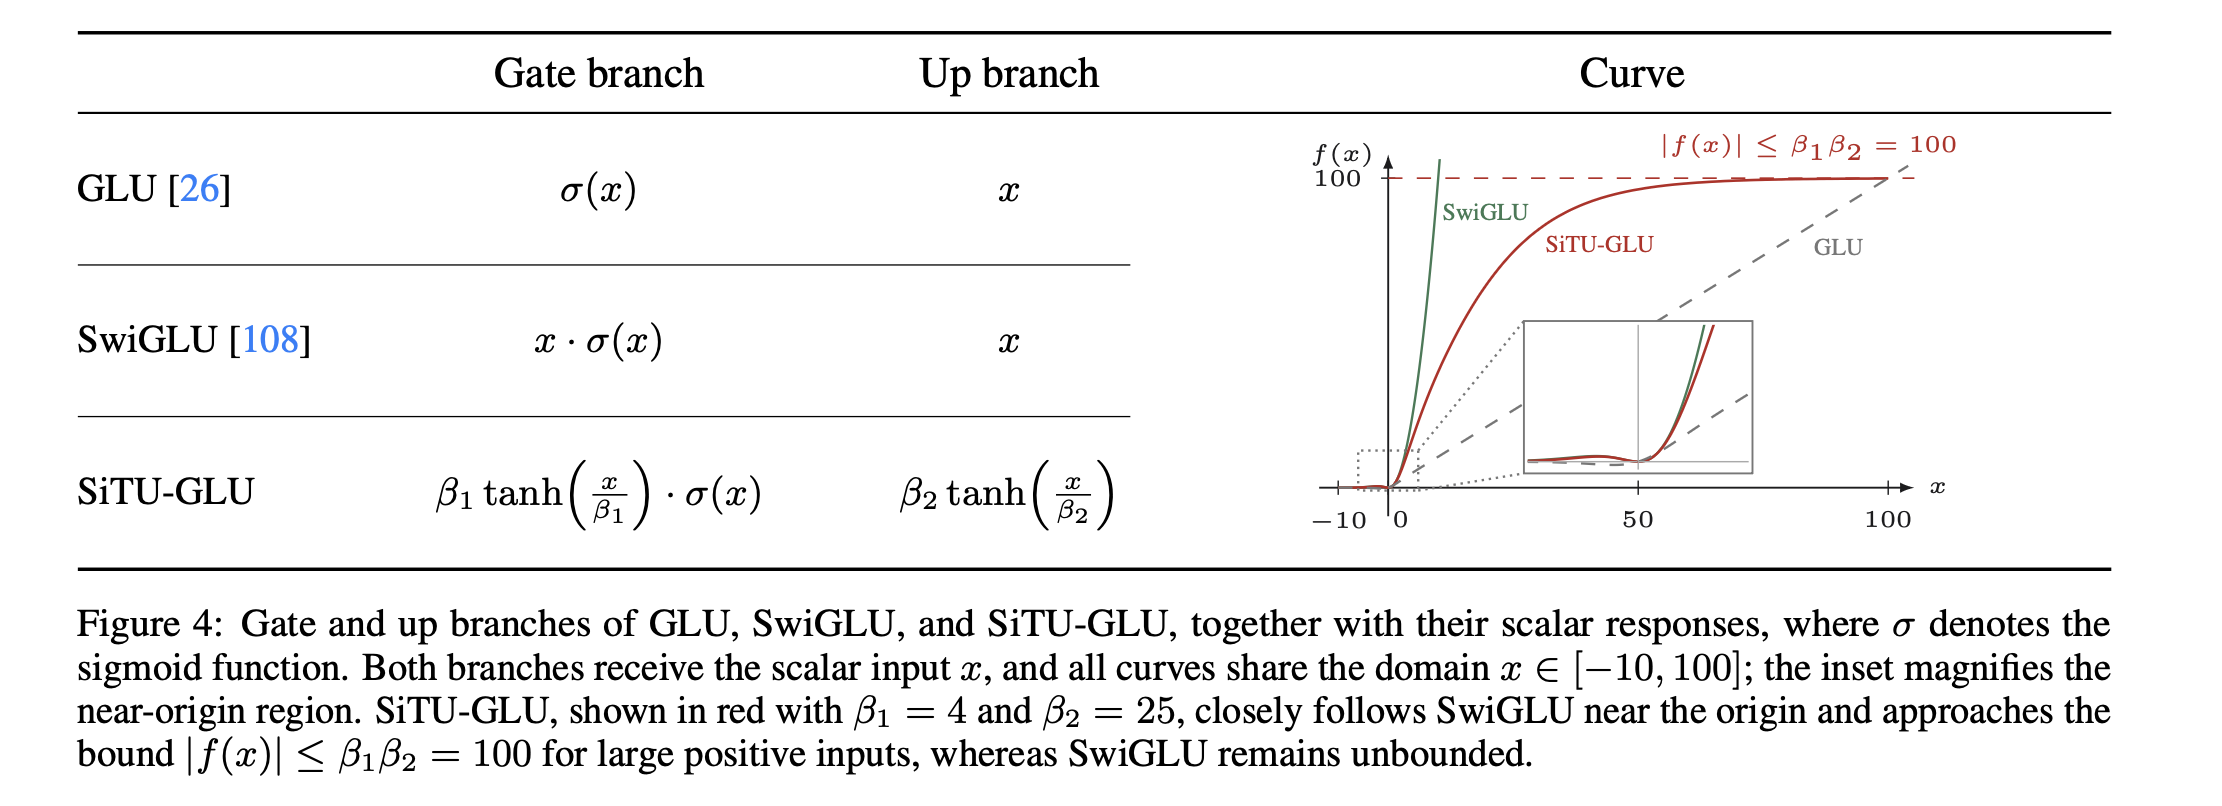
主流MoE架构通常采用SwiGLU的形式:
\[\begin{equation} \color{purple}{ \boldsymbol{W}_3(\operatorname{SiLU}(\boldsymbol{W}_1 \boldsymbol{x}) \odot \boldsymbol{W}_2 \boldsymbol{x}) } \end{equation}\]其中 $\operatorname{SiLU}(x) = x\sigma(x)$ ,而 $\sigma$ 是 Sigmiod 函数。 然而SwiGLU 一直存在的问题是它的乘法无界,这导致 $W_1$ 的某一行 $w$ 与输入 $x$ 方向相近时,会导致乘法结果异常大,所以先利用tanh函数将门控部分控制在 $(-\beta, \beta)$ 之内:
\[\begin{equation} \color{purple}{ \operatorname{SiTU}(x; \beta) = \underbrace{\beta \tanh\left(\frac{x}{\beta}\right)}_{\operatorname{softcap}(x; \beta)} \cdot \sigma(x) } \end{equation}\]再加入softcap进一步抑制膨胀:
\[\begin{equation} \color{purple}{ \boldsymbol{W}_3\Big(\operatorname{SiTU}(\boldsymbol{W}_1 \boldsymbol{x};\beta_1) \odot \operatorname{softcap}(\boldsymbol{W}_2 \boldsymbol{x};\beta_2)\Big) } \end{equation}\]Normalized LatentMoE
直观来看,MoE 和 LatentMoE 的区别:
\[\begin{equation} \begin{aligned} &\color{purple}{\text{MoE:}\qquad\qquad\underbrace{d \to D \to d}_{n\text{ 选 }k}} \\[5pt] &\color{purple}{\text{LatentMoE:}\qquad d\to\underbrace{d/2 \to D \to d/2}_{2n\text{ 选 }2k}\to d} \end{aligned} \end{equation}\]由于 LatentMoE 多了一套降维升维操作,带来了四个矩阵连乘的模式。因此一个朴素想法就是在升维前的输入加入 RMSNorm 归一化操作。其不止能稳定训练,还对效果有神奇作用。
Quantile Balancing
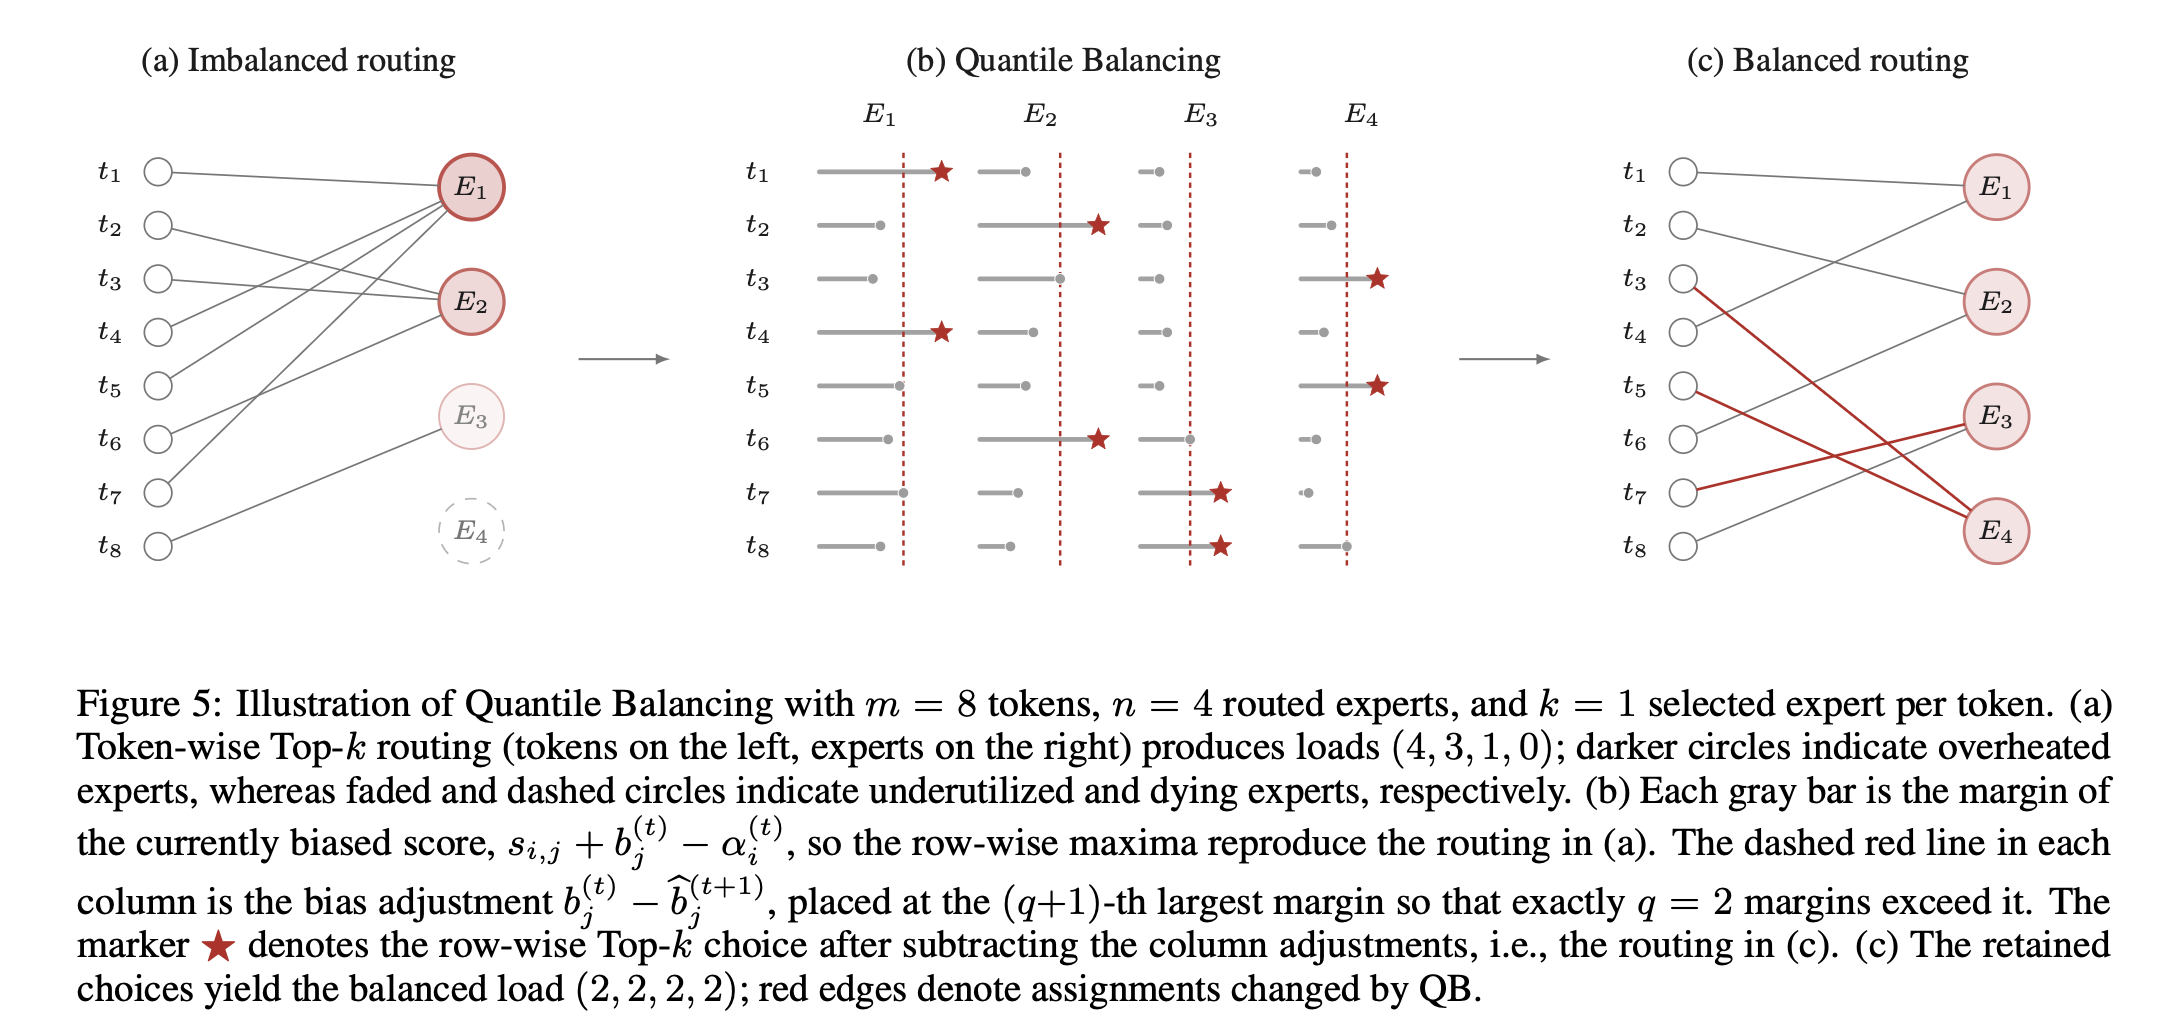
根据上文对MoE的推导,很容易发现如果不加控制,会导致某些专家永远高分,导致接收海量信息致使过载;而有的专家永远低分,导致无法得到充分训练。这样整体拖慢整个系统。而负载均衡 (auxiliary-loss-based) 就是为了避免这样的情况发生
原始的 auxiliary-loss-free 方法用固定步长更新:
\[\begin{equation} \color{purple}{ b_j^{(t+1)} = b_j^{(t)} + \gamma \operatorname{sign}(\bar{\ell} - \ell_j^{(t)}) } \end{equation}\]其中 $b$ 是对应专家的偏置。这个式子需要不断调整 $\gamma$ 这个参数,非常麻烦。而 Quantile Balancing (QB) 是一次性算出”让专家恰好收到 q 个 token”所需的值,这里的 q 就是利用分位数找到阈值。
具体来说,QB首先在 Router 阶段找到 k+1个模长最长的专家数量,而第 k+1 个就是阈值,用每个值减去阈值后,就得到了一堆大于0和小于0数字:
\[\begin{equation} \color{purple}{ \text{margin}_{i,j} = s_{i,j} - \alpha_i^{(t)} } \end{equation}\]大于0的就是被选中的,也就是专家 j 超过了 token i 的阈值。那么在候选偏置 $\widehat{b}_j^{(t+1)}$ 下,专家 j 收到的token数量为:
\[\begin{equation} \color{purple}{ \sum_{i=1}^{m} \mathbf{1}\left[s_{i,j} + \widehat{b}_j^{(t+1)} > \alpha_i^{(t)}\right] = \sum_{i=1}^{m} \mathbf{1}\left[\text{margin}_{i,j} > -\widehat{b}_j^{(t+1)}\right] } \end{equation}\]要让计数恰好等于 q ,阈值就是第 (q+1) 大的 margin,也就对应了分位数:
\[\begin{equation} \color{purple}{ \widehat{b}_j^{(t+1)} \leftarrow -\operatorname{quantile}_{1-k/n}\left(\boldsymbol{s}_{:,j} - \boldsymbol{\alpha}^{(t)}\right) } \end{equation}\]最后去均值消除冗余自由度,让偏置更稳定。
一些小模块
整体大头已经囊括进了上述的所有,而后面的小模块简单过一下,例如Native Vision是为了让k3融入多模态的知识,且无需后训练的对齐;Per-Head Muon 则并没有效果上的优势(当然也没有劣势),改用它更多是出于正确性考虑(每个Head应当相对独立的,不应耦合在一块),至于更多的对于模型架构的考量,可以关注苏神的博客,里面有更加详细的技术细节。
之后会继续更新预训练后训练模块以及infra的与hardward的co-design,敬请关注!